Gemeinsamer Cache statt wiederholter Berechnung
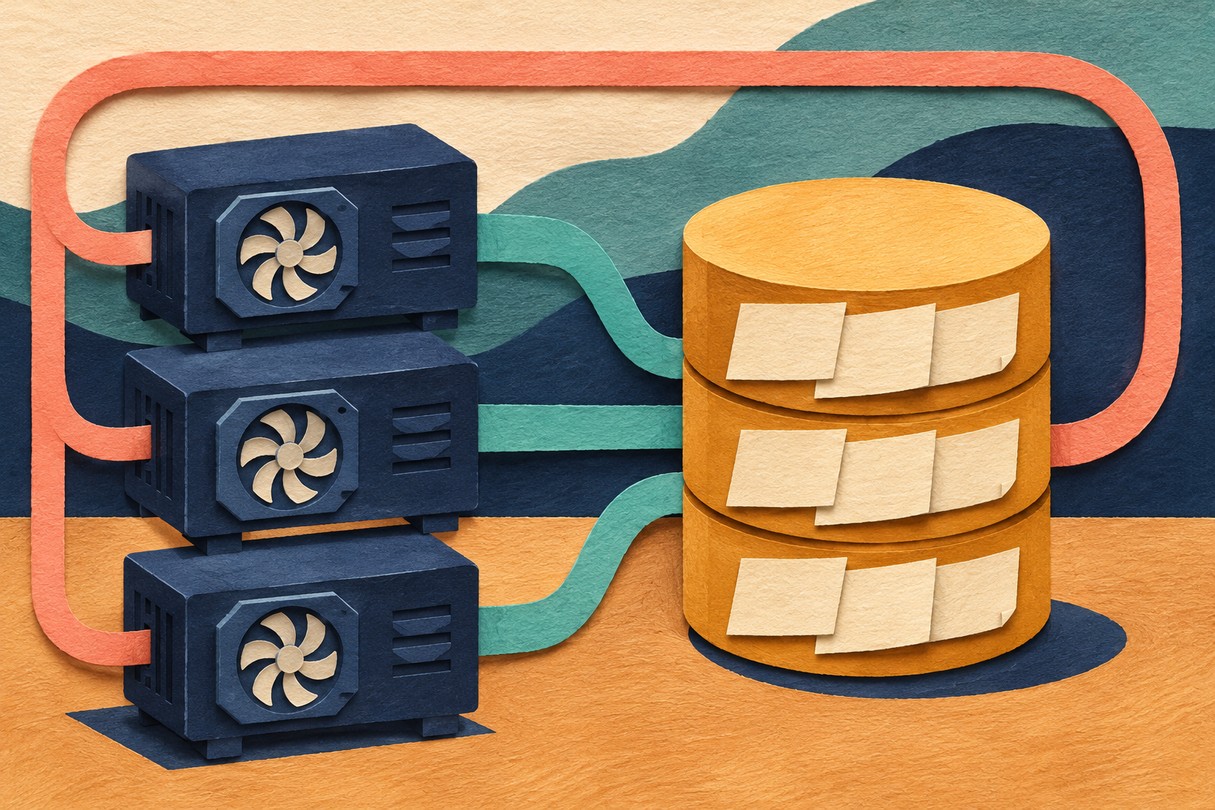
AWS hat am 18. November verteiltes KV-Caching für ElastiCache for Valkey angekündigt. Mehrere GPU-Inferenzserver können dabei bereits berechnete Kontextzustände gemeinsam wiederverwenden.
Die aktuelle Dokumentation verlangt Node-basierte Cluster mit Valkey 9.1 oder neuer und dem Node-Typ cache.i8ge.48xlarge. Sie nennt RDMA über Elastic Fabric Adapter sowie TCP als Übertragungsmöglichkeiten. Das ist keine automatische Erweiterung beliebiger vorhandener ElastiCache-Cluster.
Für welche Anwendungen es gedacht ist
AWS nennt vLLM, SGLang und TensorRT-LLM als mögliche Inferenzengines mit LMCache-Anbindung. Die tatsächliche Unterstützung hängt von Engine, LMCache und Modell ab.
Lange Sitzungen, wiederholter Kontext und verteilte GPU-Flotten sind laut Dokumentation passende Einsatzfälle. Für kurze oder nie wiederholte Prompts und Aufgaben, bei denen vor allem die Ausgabeerzeugung Zeit kostet, nennt sie einen geringen Nutzen.
Die Gebühr bleibt am Cluster hängen
Laut Preisseite fällt neben dem regulären Stundenpreis der Nodes keine zusätzliche Gebühr für diese KV-Cache-Funktion an. Der Cache-Cluster selbst bleibt kostenpflichtig, bis er gelöscht wird.
Datenübertragung zwischen Cache und GPU-Instanzen in derselben Availability Zone wird dort ohne separate Transfergebühr beschrieben. Daraus folgt keine allgemeine Gebührenfreiheit anderer Ressourcen oder Zonen.
Erst den eigenen Arbeitsablauf bewerten
AWS nennt 13 verfügbare Regionen und bietet KVTrace zur Abschätzung anhand eigener Inferenzdaten an. Die Dokumentation beschreibt Schätzungen von Trefferrate, Einsparung und Kostenschwelle vor einer Bereitstellung.
Die beworbenen maximalen Kosten- und Latenzsenkungen sind Anbieterangaben. Eine eigene Leistungsprüfung oder kostenpflichtige Clusterbereitstellung wurde für diesen Bericht nicht durchgeführt.